
OCR beim Transportauftrag: Grenzen klassischer Texterkennung
Ein Lieferschein sagt „Anlieferung am 14.3.“, der nächste vom selben Kunden „Lieferdatum: 14.03.“. Inhaltlich dasselbe, für ein klassisches OCR-Tool aber zwei völlig unterschiedliche Textfelder. Genau an diesem Punkt stößt OCR beim einzelnen Transportauftrag an klare Grenzen, unabhängig davon, wie gut die reine Zeichenerkennung selbst funktioniert.
OCR beim Transportauftrag: Grenzen der reinen Zeichenerkennung
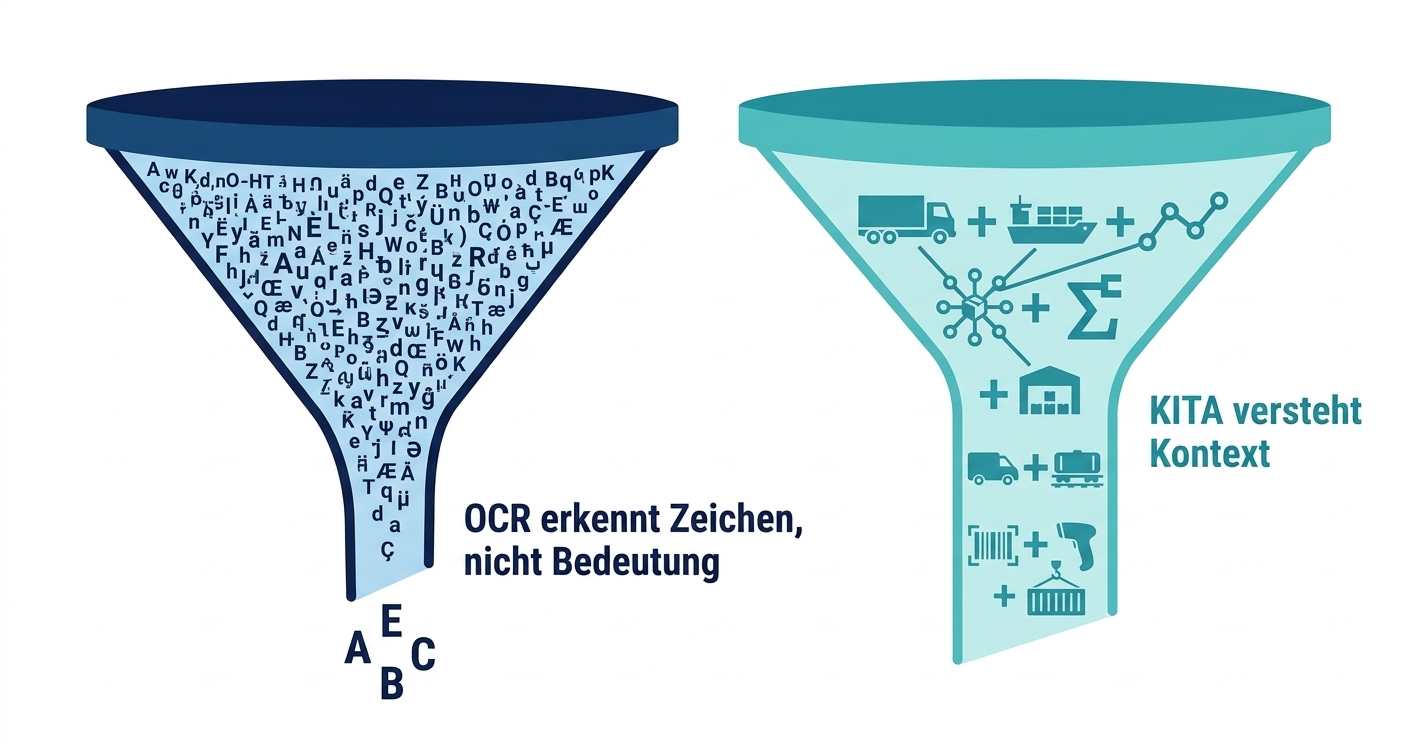
Klassisches OCR (Optical Character Recognition) erkennt zuverlässig, welche Zeichen an welcher Stelle in einem Dokument stehen. Was OCR nicht kann: verstehen, was diese Zeichen bedeuten. Ein Datum bleibt für OCR eine Zeichenfolge — ob sie „Lieferdatum“, „Anlieferung am“ oder „gewünschter Liefertermin“ heißt, macht für ein reines OCR-System keinen Unterschied, solange die exakte Position im Dokument bekannt ist. Genau hier liegt das Problem: Sobald ein Absender eine leicht andere Formulierung oder ein anderes Layout verwendet, muss das OCR-System neu angepasst werden.
KITA versteht semantisch
KITA geht als Beispiel intelligenter Dokumentenverarbeitung einen Schritt weiter: Das System erkennt, dass „Lieferdatum“ und „Anlieferung am“ inhaltlich dasselbe meinen, unabhängig von der genauen Formulierung oder Position im Dokument. Diese semantische Verarbeitung ist der entscheidende Unterschied zwischen einem System, das bei jeder neuen Absender-Formulierung händisch nachjustiert werden muss, sowie einem System, das mit der natürlichen Variationsbreite echter Geschäftskorrespondenz zurechtkommt.
| Klassisches OCR | KITA | |
|---|---|---|
| Erkennt Zeichen | Ja | Ja |
| Versteht Bedeutung | Nein | Ja |
| Neue Formulierung eines Absenders | Muss manuell nachjustiert werden | Wird ohne Anpassung verstanden |
Ein Beispiel aus dem Alltag
Zwei Verlader schicken denselben Auftragstyp an dieselbe Spedition. Der eine schreibt „Lieferdatum: 14.03.”, der andere formuliert im Fließtext „bitte Anlieferung am 14. März sicherstellen”. Für ein klassisches OCR-System, das auf ein festes Formularlayout trainiert wurde, ist die zweite Variante ein Problem: Es gibt kein festes Feld „Lieferdatum”, die Information steckt mitten im Satz. KITA erkennt in beiden Fällen dieselbe Bedeutung, unabhängig davon, ob die Angabe in einem strukturierten Feld oder im freien Text steht.
Weitere typische Grenzfälle im Speditionsalltag
Das Beispiel mit dem Lieferdatum ist nur einer von mehreren wiederkehrenden Fällen, an denen reines OCR im Auftragseingang scheitert. Ein gescannter Lieferschein mit handschriftlichen Ergänzungen am Rand, etwa einer nachträglich notierten Sonderanweisung, wird von OCR oft gar nicht oder falsch erfasst, weil Handschrift stark von der trainierten Schriftart abweicht. Tabellen innerhalb eines PDFs, in denen mehrere Positionen mit unterschiedlichen Lieferadressen aufgelistet sind, bringen OCR-Systeme regelmäßig durcheinander, weil die Zuordnung von Zelle zu Zeile allein aus der visuellen Position nicht immer eindeutig ist. Und mehrseitige Anhänge, bei denen die eigentliche Auftragsinformation erst auf Seite zwei oder drei steht, werden von einfachen OCR-Workflows häufig gar nicht bis dorthin durchsucht.
Wo klassisches OCR weiterhin sinnvoll bleibt
Das heißt nicht, dass OCR grundsätzlich ungeeignet ist. Bei streng standardisierten Formularen mit immer demselben Layout, etwa bei einem einzelnen Großkunden mit fester EDI-Anbindung, arbeitet reines OCR zuverlässig und mit geringem technischen Aufwand. Die Grenzen zeigen sich erst dort, wo mehrere Absender mit unterschiedlichen Formaten, freiem Fließtext und wechselnden Formulierungen aufeinandertreffen, also genau in der Situation, die im Speditionsalltag mit vielen unterschiedlichen Kunden eher die Regel als die Ausnahme ist.
Die wichtigsten Begriffe kurz erklärt
| Begriff | Kurzerklärung |
|---|---|
| OCR | Optical Character Recognition, erkennt Zeichen anhand ihrer Form, ohne deren Bedeutung zu verstehen |
| Semantische Verarbeitung | Auswertung von Inhalten nach Bedeutung statt nach fester Position im Dokument |
| EDI | Electronic Data Interchange, standardisierter, strukturierter Datenaustausch zwischen zwei Systemen |
| Embedding | Mathematische Darstellung von Begriffen, bei der ähnliche Bedeutungen nah beieinanderliegen |
Diese vier Begriffe erklären zusammen, warum der Unterschied zwischen OCR und semantischer Verarbeitung mehr ist als reine Fachterminologie: EDI funktioniert nur, weil beide Seiten sich vorab auf ein festes Format geeinigt haben, genau diese Voraussetzung fehlt bei offenen E-Mail-Eingängen mit vielen unterschiedlichen Absendern.
Zwei Säulen: Auftragserfassung + Workflow
KITA besteht dabei nicht nur aus der reinen Erkennung, sondern aus zwei zusammenhängenden Säulen.
Säule 1: KI-Auftragserfassung
Sie versteht Dokumente semantisch, unabhängig von Formulierung oder Layout des Absenders. Grundlage dafür ist Künstliche Intelligenz respektive Sprachverarbeitung, die Inhalte nach Bedeutung statt nach fester Position im Dokument auswertet. Technisch werden Begriffe dabei als Embeddings verglichen, eine Darstellung, in der inhaltlich ähnliche Begriffe wie „Lieferdatum“ und „Anlieferung am“ nahe beieinanderliegen, obwohl sie als Zeichenketten völlig unterschiedlich aussehen. Genau dieser Mechanismus erlaubt es, neue Formulierungen zu verstehen, ohne für jeden Absender eine eigene Regel pflegen zu müssen.
Säule 2: Workflow-Komponente
Sie validiert die extrahierten Daten und überträgt sie ins TMS. Der typische Fehlerfall für reines OCR, unstrukturierte E-Mails mit freiem Fließtext oder uneinheitliche Formulare unterschiedlicher Absender, ist genau der Fall, für den diese Kombination gebaut wurde. Fehlt eine Pflichtangabe oder wirkt ein Wert unplausibel, etwa ein Liefertermin in der Vergangenheit, markiert die Workflow-Komponente den Auftrag zur manuellen Prüfung, statt ihn ungeprüft ins TMS zu übernehmen.
Zu den geprüften Kriterien gehören unter anderem: Ist ein Pflichtfeld wie Lieferadresse oder Liefertermin überhaupt vorhanden? Liegt ein erkanntes Datum in einem plausiblen Zeitraum? Stimmt die erkannte Postleitzahl mit dem genannten Ort überein? Erst wenn alle Prüfungen erfolgreich durchlaufen sind, wird der Auftrag automatisch ins TMS übertragen. Bei einer Auffälligkeit landet er stattdessen in einer Prüfliste für die manuelle Kontrolle, mit einem Hinweis, welches Kriterium genau nicht erfüllt war.
Was das für die Anbindung ans bestehende TMS bedeutet
Weil KITA die Daten bereits geprüft und strukturiert bereitstellt, bleibt die Integration ins bestehende System unabhängig von der Frage, wie unterschiedlich die eingehenden Dokumente ursprünglich formatiert waren. Die Anbindung selbst läuft dabei per REST-API oder CSV/XML-Import, ohne die bestehende Systemlandschaft abzulösen, mehr dazu unter ki-auftragserfassung.de.
Was ist der Unterschied zwischen OCR und KI-Auftragserfassung?
OCR erkennt nur Zeichen, ohne deren Bedeutung zu verstehen. KI-Auftragserfassung wie KITA versteht semantisch, dass unterschiedliche Formulierungen dasselbe meinen.
Warum reicht reines OCR bei Transportaufträgen oft nicht?
Weil Absender unterschiedliche Formulierungen und Layouts verwenden — OCR müsste bei jeder Abweichung neu angepasst werden.
Aus welchen Komponenten besteht KITA?
Aus zwei Säulen: der KI-Auftragserfassung selbst und einer Workflow-Komponente, die Daten validiert und ins TMS überträgt.
Ist OCR grundsätzlich ungeeignet für Transportaufträge?
Nein — bei streng standardisierten Formularen eines einzelnen Absenders arbeitet OCR zuverlässig. Die Grenzen zeigen sich erst bei vielen unterschiedlichen Formaten und freiem Fließtext.
Was passiert, wenn eine Angabe im Auftrag unplausibel wirkt?
Die Workflow-Komponente markiert den Auftrag zur manuellen Prüfung, statt ihn ungeprüft ins TMS zu übernehmen.
Kann KITA auch handschriftliche Ergänzungen erfassen?
Handschrift ist grundsätzlich schwieriger zu erfassen als gedruckter Text — bei stark handschriftlich geprägten Dokumenten empfiehlt sich eine vorherige Prüfung im Einzelfall.
Was passiert bei mehrseitigen Dokumenten?
Die relevanten Informationen werden über alle Seiten hinweg gesucht, nicht nur auf der ersten — anders als bei vielen einfachen OCR-Workflows.
Wie eine Einführung planbar gelingt, sobald die technische Seite geklärt ist, beschreiben wir in unserem Artikel zur Software-Einführung im Betrieb. Wer die semantische Verarbeitung am eigenen Auftragseingang testen will, findet unter ki-auftragserfassung.de weitere Details.
Transparenzhinweis: Bei der Erstellung dieses Beitrags kam KI-Unterstützung zum Einsatz.